引数設定: M=母集団サイズ, N=母集団内のアタリ数, N=抽出サンプル数
データサイエンスや品質管理の実務、あるいは統計検定の対策において、多くの学習者が最初の壁として直面するのが「超幾何分布」の理解です。高校数学で学ぶ反復試行の確率(二項分布)と似ているようでいて、計算の前提や数式のアプローチが根本から異なるため、混同したまま試験本番で失点したり、実務のサンプリング設計で思わぬ推定誤差を生むケースが後を絶ちません。
本稿では、超幾何分布の数学的メカニズムから非復元抽出の本質、期待値・分散の導出プロセス、さらにはPythonやR言語による実装コードやフィッシャーの正確確率検定との連動性まで、現場目線で論理的に解き明かします。
📌 【この記事の重要ポイントまとめ】
- 要点1:超幾何分布は「引いたものを元に戻さない(非復元抽出)」状況下で、特定の結果が何回現れるかを記述する離散型確率分布である。
- 要点2:期待値は二項分布と同じ「$np$」となる一方、分散には母集団の有限性を反映する「有限母集団修正係数 $\frac{N-n}{N-1}$」が掛かる。
- 要点3:母集団サイズ $N$ に対して抽出数 $n$ が十分に小さい場合(目安として5%〜10%以下)、二項分布へ極限近似できる。
【2026年最新解説】超幾何分布の基礎と非復元抽出の仕組み
超幾何分布(Hypergeometric Distribution)を最も直感的に表現するなら、「元に戻さないくじ引きの確率モデル」です。
統計学で扱うサンプリングには、一度取り出した要素を元に戻してから次を引く「復元抽出」と、元に戻さずに次の要素を引く「非復元抽出」の2系統が存在します。コイン投げやサイコロのように、何回試行を重ねても各回の成功確率が一定(独立試行)であれば二項分布の守備範囲です。しかし、有限の母集団から要素を抜き取っていく非復元抽出では、1回引くごとに残された要素の構成比が変動し、試行同士が従属関係となります。この従属関係を厳密に定式化したものが超幾何分布です。
数学的な定義を整理しましょう。全体で $N$ 個の要素があり、その中に特定の属性を持つ要素(アタリ)が $M$ 個、持たない要素(ハズレ)が $N-M$ 個含まれているとします。この母集団から非復元抽出で $n$ 個のサンプルを取り出したとき、その中に含まれるアタリの個数 $X$ が従う確率質量関数(PMF: Probability Mass Function)は以下の数式で定義されます。
$$P(X = k) = \frac{\binom{M}{k} \binom{N-M}{n-k}}{\binom{N}{n}}$$
ここで $k$ は抽出されたアタリの個数であり、定義域は $\max(0, n - (N - M)) \le k \le \min(n, M)$ となります。分母は「全体 $N$ 個から $n$ 個を選ぶ全組み合わせ」、分子は「アタリ $M$ 個から $k$ 個を選ぶ組み合わせ」と「ハズレ $N-M$ 個から残り $n-k$ 個を選ぶ組み合わせ」の積です。高校数学で扱う「玉の取り出し問題」そのものが、超幾何分布のプロトタイプといえます。
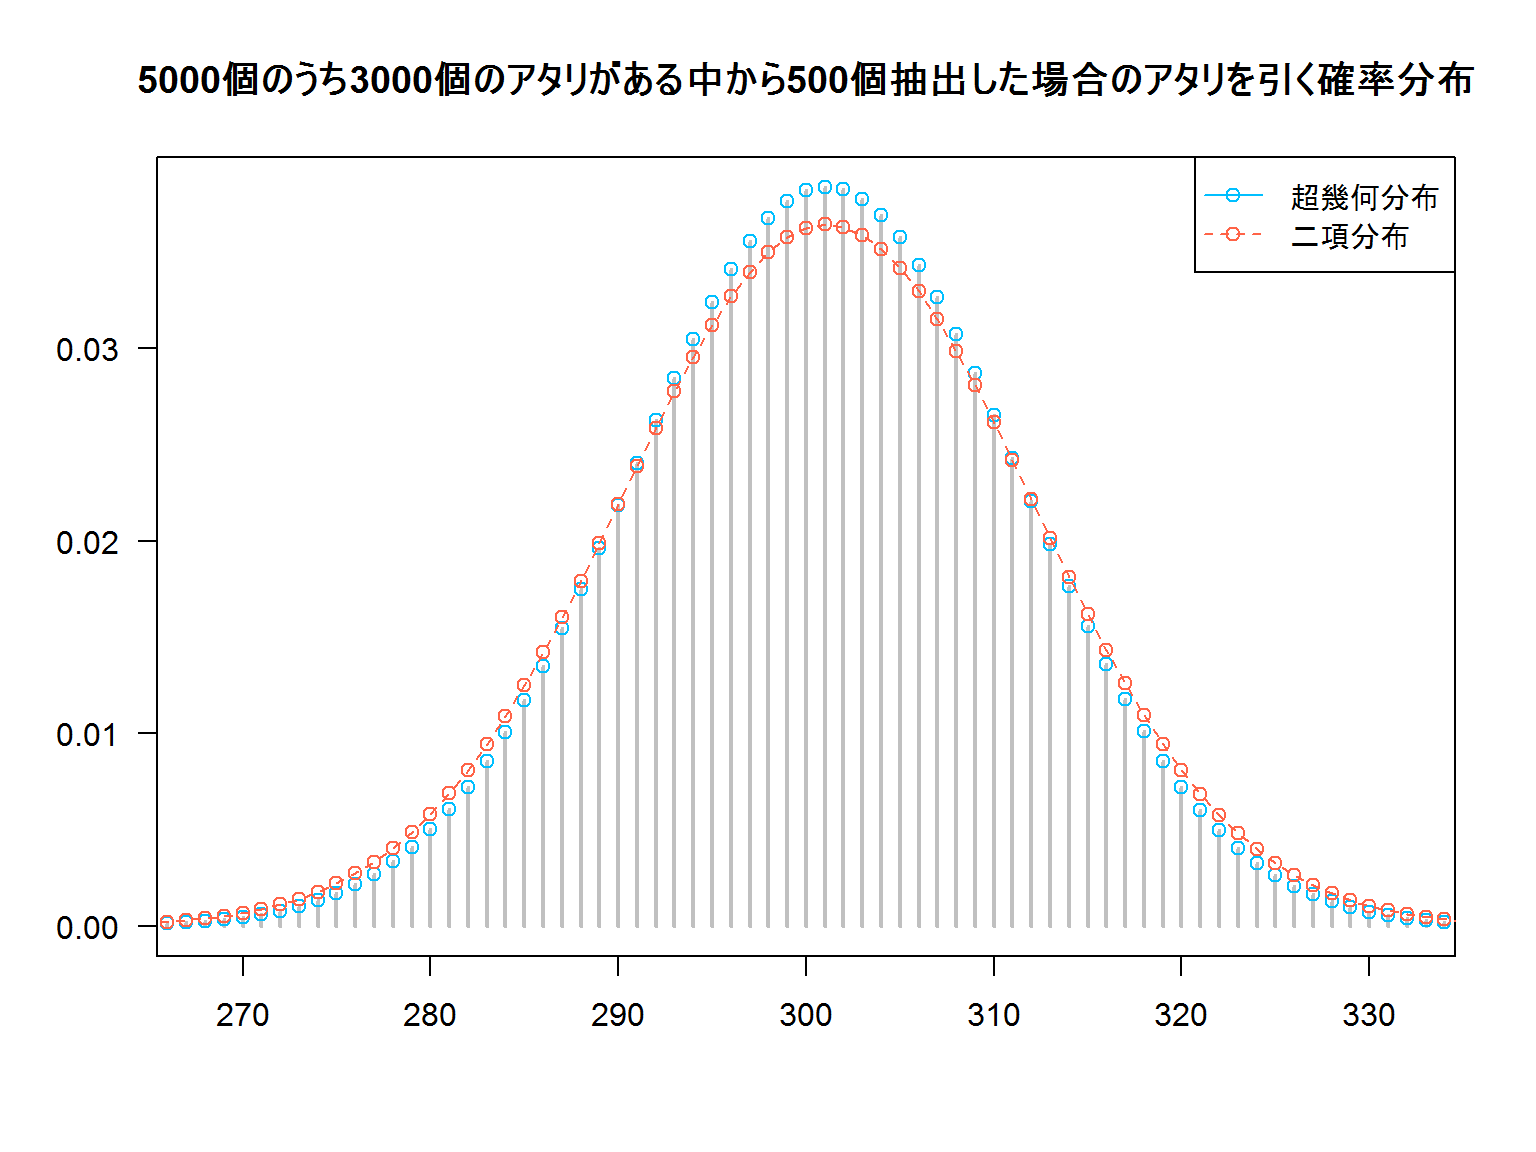
二項分布との決定的な違い|復元・非復元抽出のメカニズム比較表
二項分布と超幾何分布を取り違えると、特にサンプルサイズが母集団に対して無視できない比率を占める場面で重大な統計的バイアスを招きます。両者の性質の違いを構造的に比較したデータが以下の通りです。
| 項目 | 超幾何分布(Hypergeometric) | 二項分布(Binomial) | 編集部の見解・評価 |
|---|---|---|---|
| 抽出方法 | 非復元抽出(元に戻さない) | 復元抽出(毎回元に戻す) | 現実の抜き取り検査やアンケートは非復元が基本 |
| 各試行の独立性 | 従属(過去の抽出結果が影響) | 独立(各試行の確率は常に一定 $p$) | 独立性を仮定できない場面で超幾何分布が必須 |
| 確率質量関数 | $P(X=k) = \frac{\binom{M}{k} \binom{N-M}{n-k}}{\binom{N}{n}}$ | $P(X=k) = \binom{n}{k} p^k (1-p)^{n-k}$ | 二項分布のほうが計算負荷が大幅に低い |
| 期待値 $E[X]$ | $n \frac{M}{N} = np$ | $np$ | 初期成功割合 $p=M/N$ と置くと完全に一致する |
| 分散 $V[X]$ | $np(1-p) \times \mathbf{\frac{N-n}{N-1}}$ | $np(1-p)$ | 修正係数により、超幾何分布のほうが分散が小さくなる |
特に注目すべきは分散の項目です。超幾何分布の分散には $\frac{N-n}{N-1}$(有限母集団修正係数) が掛けられています。$n=N$(母集団をすべて抜き取る)の極限を考えると、この係数は $0$ となり、分散はゼロになります。母集団全体を調べればアタリの数は確定するため、ばらつきが消滅するという直感と完全に一致します。
【数式と証明】期待値と分散の導出プロセスを丁寧に読み解く
統計検定1級や準1級の論述試験でも頻出となるのが、超幾何分布の期待値および分散の導出です。定義式から直接総和($\sum$)を計算する手法と、指示確率変数(インジケーター)を用いる手法がありますが、ここでは本質が見えやすい指示変数法を中心に解説します。
指示確率変数を用いた期待値 $E[X]$ の導出
$i$ 番目に引いた要素がアタリであれば $1$、ハズレであれば $0$ をとる確率変数を $I_i$ と置きます($i = 1, 2, \dots, n$)。抽出されたアタリの総数 $X$ は $X = \sum_{i=1}^n I_i$ と表せます。
ここで、何番目に引くかにかかわらず、$i$ 回目にアタリを引く確率は常に事前確率と同じ $\frac{M}{N}$ です(対称性より)。したがって、$E[I_i] = 1 \cdot P(I_i = 1) + 0 \cdot P(I_i = 0) = \frac{M}{N} = p$ となります。期待値の線形性より、以下のように求まります。
$$E[X] = E\left[\sum_{i=1}^n I_i\right] = \sum_{i=1}^n E[I_i] = \sum_{i=1}^n p = np$$
分散 $V[X]$ と有限母集団修正の導出
分散の計算では、各試行の共分散(相関)を処理する必要があります。
$$V[X] = \sum_{i=1}^n V[I_i] + \sum_{i \neq j} \operatorname{Cov}(I_i, I_j)$$
$I_i$ はベルヌーイ試行であるため、$V[I_i] = p(1-p)$ です。次に $i \neq j$ における共分散を求めます。 $E[I_i I_j] = P(I_i = 1 \cap I_j = 1) = \frac{M}{N} \times \frac{M-1}{N-1}$ であるため、
$$\operatorname{Cov}(I_i, I_j) = E[I_i I_j] - E[I_i]E[I_j] = \frac{M(M-1)}{N(N-1)} - \left(\frac{M}{N}\right)^2 = -\frac{M(N-M)}{N^2(N-1)} = -\frac{p(1-p)}{N-1}$$
共分散が負の値を取る点がポイントです。「1回アタリを引くと、次にアタリを引く確率が下がる」という非復元抽出の性質が、負の相関として数式に現れています。これを全体の分散式に代入すると、
$$V[X] = n p(1-p) + n(n-1) \left( -\frac{p(1-p)}{N-1} \right) = np(1-p) \left( 1 - \frac{n-1}{N-1} \right) = np(1-p) \left( \frac{N-n}{N-1} \right)$$
このようにして、二項分布の分散 $np(1-p)$ に対し、非復元抽出に起因する補正項 $\frac{N-n}{N-1}$ が導出されます。
なお、超幾何分布のモーメント母関数(積率母関数)は、ガウスの超幾何級数($_2F_1$)を用いた極めて複雑な関数形をとるため、通常の初等的なモーメント母関数の微分による導出は実用的ではありません。上記のようなインジケーター分解や、階乗モーメントの総和計算から導出するのが標準的です。

【実戦例題と実装】Python・R言語での計算とフィッシャーの検定
理論を定着させるために、具体的な抜き取り検査のシナリオで確率を計算してみましょう。
計算例題:工場ロットの抜き取り検査
【問題】 100個の製品が入ったロットがあり、そのうち10個が不良品であるとする。このロットからランダムに5個を非復元抽出したとき、不良品がちょうど2個含まれる確率を求めよ。
【解答】 $N=100, M=10, n=5, k=2$ を確率質量関数に代入します。
$$P(X=2) = \frac{\binom{10}{2} \binom{90}{3}}{\binom{100}{5}} = \frac{45 \times 117,480}{75,287,520} = \frac{5,286,600}{75,287,520} \approx 0.07022 \quad (\mathbf{約7.02\%})$$
Python(scipy.stats)による実装
Pythonの `scipy.stats.hypergeom` を利用する場合、引数のマッピングに注意が必要です。SciPyでは $M$ が全体数($N$)、$n$ が全体中のアタリ数($M$)、$N$ がサンプル数($n$) と定義されています。
from scipy.stats import hypergeom M_total = 100 # 全体数 (N) n_target = 10 # 不良品数 (M) N_sample = 5 # サンプル数 (n) k_found = 2 # 検知したい不良品数 (k) # ちょうど2個含まれる確率 (PMF) prob = hypergeom.pmf(k_found, M_total, n_target, N_sample) print(f"P(X=2) = {prob:.5f}") # 出力: P(X=2) = 0.07022 # 期待値と分散の取得 mean, var = hypergeom.stats(M_total, n_target, N_sample, moments='mv') print(f"期待値: {mean:.2f}, 分散: {var:.4f}") R言語(dhyper)による実装
R言語では組み込み関数の `dhyper` を使用します。引数は `dhyper(x, m, n, k)` であり、$m$ はアタリ数、$n$ はハズレ数、$k$ は抽出数 を指定します。
# R言語による計算 m <- 10 # アタリの総数 n_fail <- 90 # ハズレの総数 (100 - 10) k_draw <- 5 # 抽出サンプル数 x <- 2 # アタリの抽出数 prob <- dhyper(x, m = m, n = n_fail, k = k_draw) cat("P(X=2) =", round(prob, 5), "\n") 医学・臨床試験で多用される「フィッシャーの正確確率検定」との接点
超幾何分布の実務応用として最も有名なのが、分割表におけるフィッシャーの正確確率検定(Fisher's Exact Test)です。サンプルサイズが小さい臨床試験(新薬の有効・無効比較など)において、2×2分割表の行・列の合計(周辺度数)を固定した条件下で、観測された度数分布が生じる確率は超幾何分布そのものです。カイ二乗検定のように近似を用いず、厳密な $p$ 値を算出できるため、小標本データの仮説検定におけるゴールドスタンダードとして君臨しています。
【実態検証】学習現場で多発する誤解と「二項分布近似」の落とし穴
統計検定の受験者コミュニティやデータサイエンスの現場において、毎年繰り返される典型的なミスが「非復元抽出であるにもかかわらず、無条件で二項分布の公式を使ってしまう」ことです。
理論上、母集団サイズ $N$ が抽出サンプル数 $n$ に比べて圧倒的に大きい場合、1回引いたところで全体の成功比率 $p = M/N$ はほとんど変動しません。そのため、$\lim_{N \to \infty} \frac{N-n}{N-1} = 1$ となり、超幾何分布は二項分布へと収束(近似)します。
しかし、現場での問題は「どの程度なら二項分布で近似してよいのか」という境界線の判断です。
二項分布近似を適用してよい基準と危険なケース
- 近似が安全な領域(抽出率 $n/N \le 0.05$): サンプル数が母集団の5%以下であれば、修正係数は $0.95$ 以上となり、二項分布で代用しても実務上の誤差は軽微です。
- 近似が危険な領域(抽出率 $n/N > 0.10$): サンプル数が母集団の10%を超える場合、二項分布を使うと分散を過大評価(リスクを過大に見積もる、あるいは信頼区間が無駄に広がる)してしまいます。
特に品質管理の受入サンプリング検査では、1ロット数十個〜数百個に対して十数個を抜き取るケースが多く、抽出率が20%〜30%に達することも珍しくありません。この状況で二項分布を用いると、不良率の推定精度が著しく狂うため、厳密な超幾何分布の適用が不可欠です。
【プロの結論】超幾何分布と二項分布の使い分け判断フロー
実務および試験対策における使い分けは、以下の3ステップで機械的に判断するのが確実です。
- ステップ1(抽出条件の確認): 試行が復元抽出か? → 二項分布 を採用。
- ステップ2(母集団の有限性): 非復元抽出で、母集団サイズ $N$ が未知または無限とみなせるか? → 二項分布 で十分。
- ステップ3(抽出率の閾値): 非復元抽出で母集団 $N$ が有限かつ判明しており、抽出比率 $\frac{n}{N} > 0.05$ か? → 迷わず 超幾何分布 を選択。

【超幾何分布】に関するよくある質問(FAQ)
Q1:超幾何分布の名前の由来は何ですか?なぜ「幾何」と付くのでしょうか?
A1:数学における「超幾何級数(Hypergeometric series)」の各項の比率構造が、この分布の確率の比率関係と一致することに由来しています。幾何分布(幾何級数に基づく分布)をさらに一般化・拡張した数式構造を持っているため「超幾何」と呼ばれます。
Q2:ポアソン分布との関係はどうなっていますか?
A2:母集団サイズ $N$ が非常に大きく、アタリの割合 $p = M/N$ が極めて小さい(稀な事象)場合、超幾何分布は二項分布を経由してポアソン分布 $\mathrm{Po}(\lambda)$(ただし $\lambda = np$)に近似できます。工場でのごく稀な不良品発生解析などに用いられます。
Q3:統計検定2級や準1級で出題される過去問の傾向は?
A3:2級では「小規模な母集団からの抜き取り確率の計算」や「期待値・分散の公式を正しく選べるか」が問われます。準1級以上では「インジケーターを用いた期待値・分散の証明」や「二項分布近似の極限定理」「フィッシャーの検定との関連」が論述・穴埋めで頻出です。
まとめ:統計実務と試験対策で超幾何分布をマスターする判断基準
超幾何分布の本質は、「母集団の有限性と非復元抽出による確率の連動」を正確に捉える点にあります。二項分布との違いを「復元の有無」と「有限母集団修正係数 $\frac{N-n}{N-1}$ の存在」という2点に集約して理解しておけば、数式の暗記に頼ることなく、どのような応用問題や実務課題にも柔軟に対応可能です。
サンプリング比率が無視できないデータ分析や、小規模標本を扱う臨床・品質管理の現場では、超幾何分布の正しい適用が推定の精度を左右します。今回解説した定義式・導出法・コード実装を武器に、確率統計の実践力を確実なものにしてください。 (出典: 超 幾何 分布(Yahoo!ニュース))
情報を整理して届けることが得意なWebディレクター。ユーザー視点に立った記事作成を目指しています。
